유니코드 정규화
EmEditor는 Unicode 문자와 시퀀스를 정규화하는 기능을 지원합니다. 텍스트 정규화가 유용한 한 가지 예는 여러 소스의 Unicode 입력을 포함하는 데이터 세트가 있는 경우입니다. 동등한 문자를 더 쉽게 일치시키려면 모든 문자열을 단일 형식으로 정규화하는 것이 좋습니다.
UAX #15 Unicode Normalization Forms에서는 문자와 시퀀스를 정규화하는 네 가지 알고리즘인 정규 구성, 정규 분해, 호환 구성, 호환 분해를 설명합니다.
분해는 문자를 더 작은 단위로 나누는 프로세스입니다. 단일 문자 ñ(LATIN SMALL LETTER N WITH TILDE)에 정규 분해를 적용하고 문자 코드 값(Ctrl+I)을 확인하면 해당 시퀀스가 이제 LATIN SMALL LETTER N; COMBINING TILDE의 두 문자임을 알 수 있습니다. 정규 구성은 이전 명령을 되돌립니다.
모든 정규 동등성은 호환되지만 모든 호환 관계가 정규적으로 동등한 것은 아닙니다. 정규적으로 동등한 형식은 이전 ñ 예에서처럼 모양과 의미가 동일합니다.
반면에 두 호환 형식은 약간 다르게 보일 수 있으며 특정 상황에서만 동일한 의미를 가집니다. ¼과 1/4는 호환 형식이지만 정규적으로 동등하지 않습니다. ¼은 1/4과 약간 다르게 보입니다. ¼은 “4분의 1”을 의미하는 반면 1/4은 때때로 “1을 4로 나눈 값”을 의미하므로 특정 상황에서만 상호 교환할 수 있습니다.
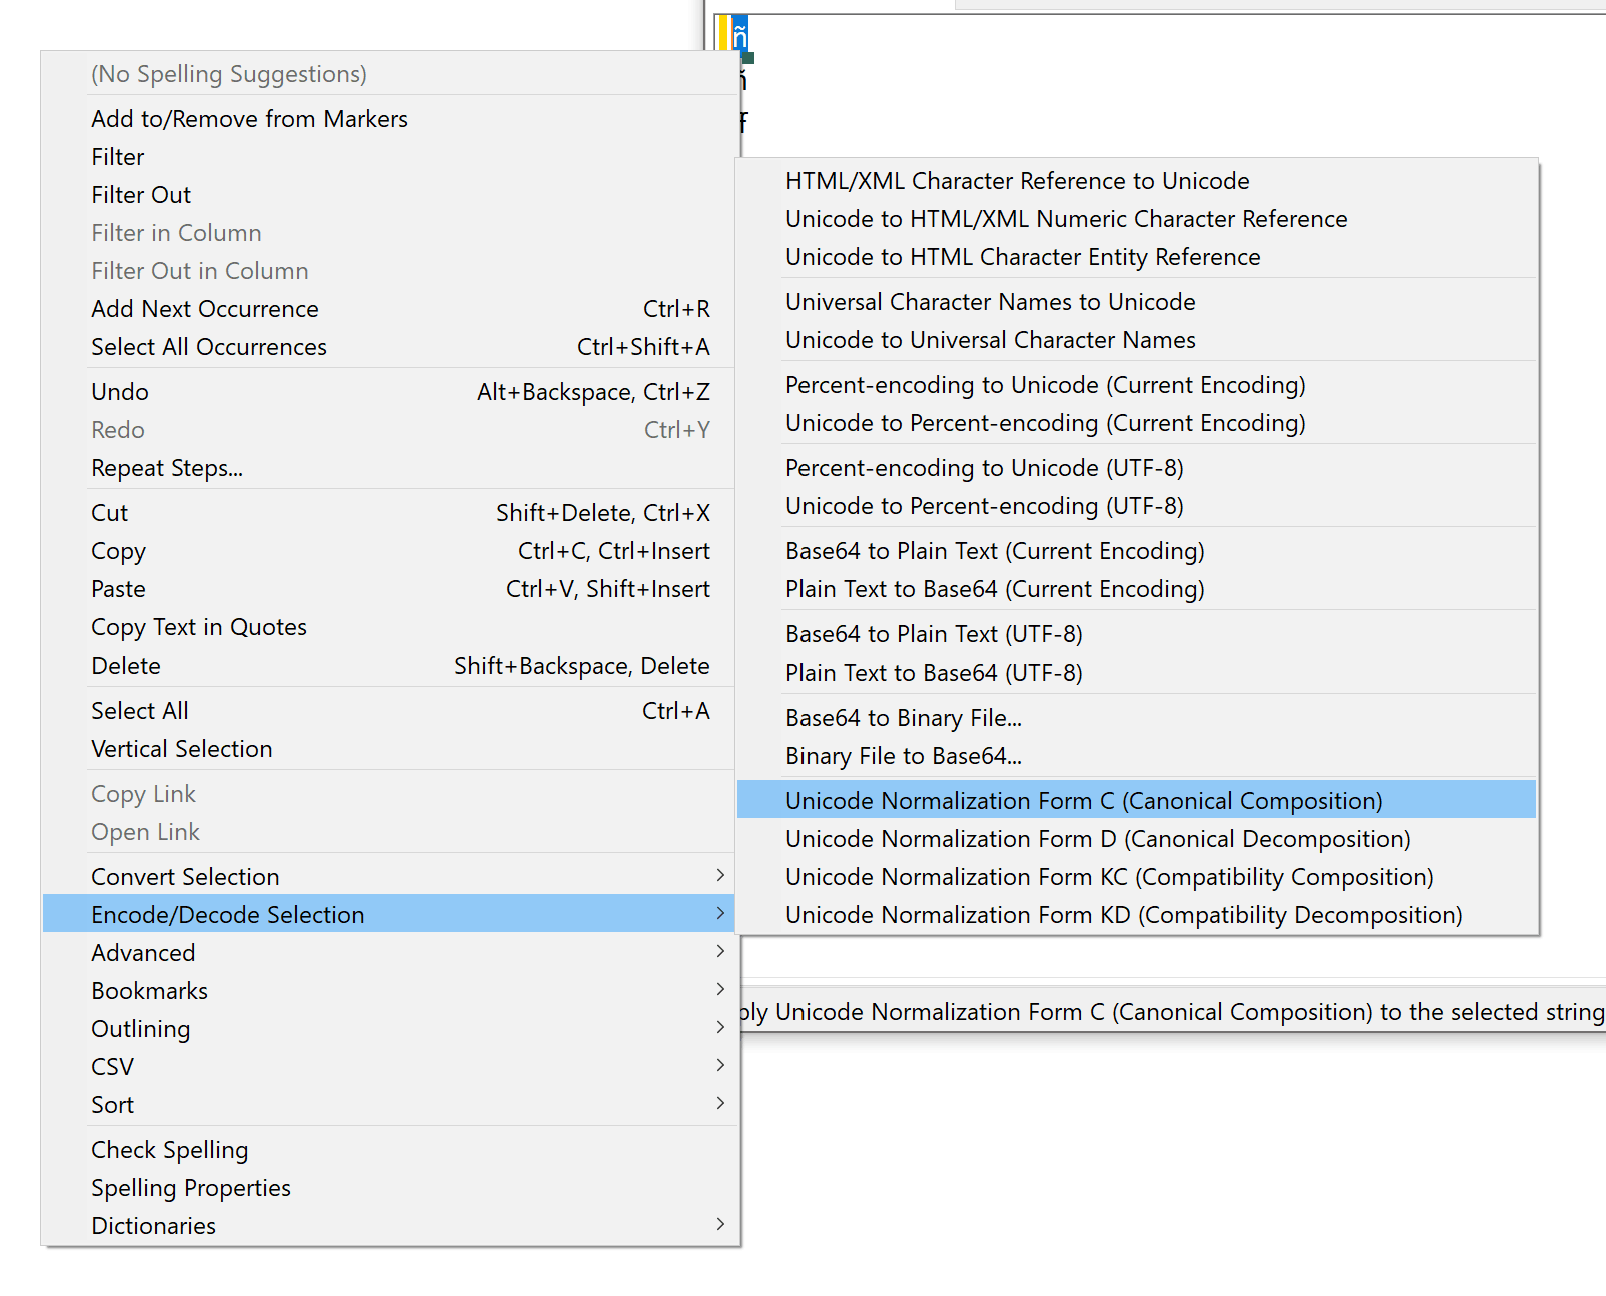
정규화 명령은 변환 > 인코딩/디코딩을 통해 액세스할 수 있습니다.